
早上 9 点,公司的考勤系统又崩了。
几千号人挤在地铁里疯狂刷新,运维群里瞬间炸锅:”加机器!扩容!”三台新服务器顶上去,页面还是转圈圈。最后查出来,三台应用服务器 CPU 才 30%,数据库的 CPU 已经 100% 直接躺平。
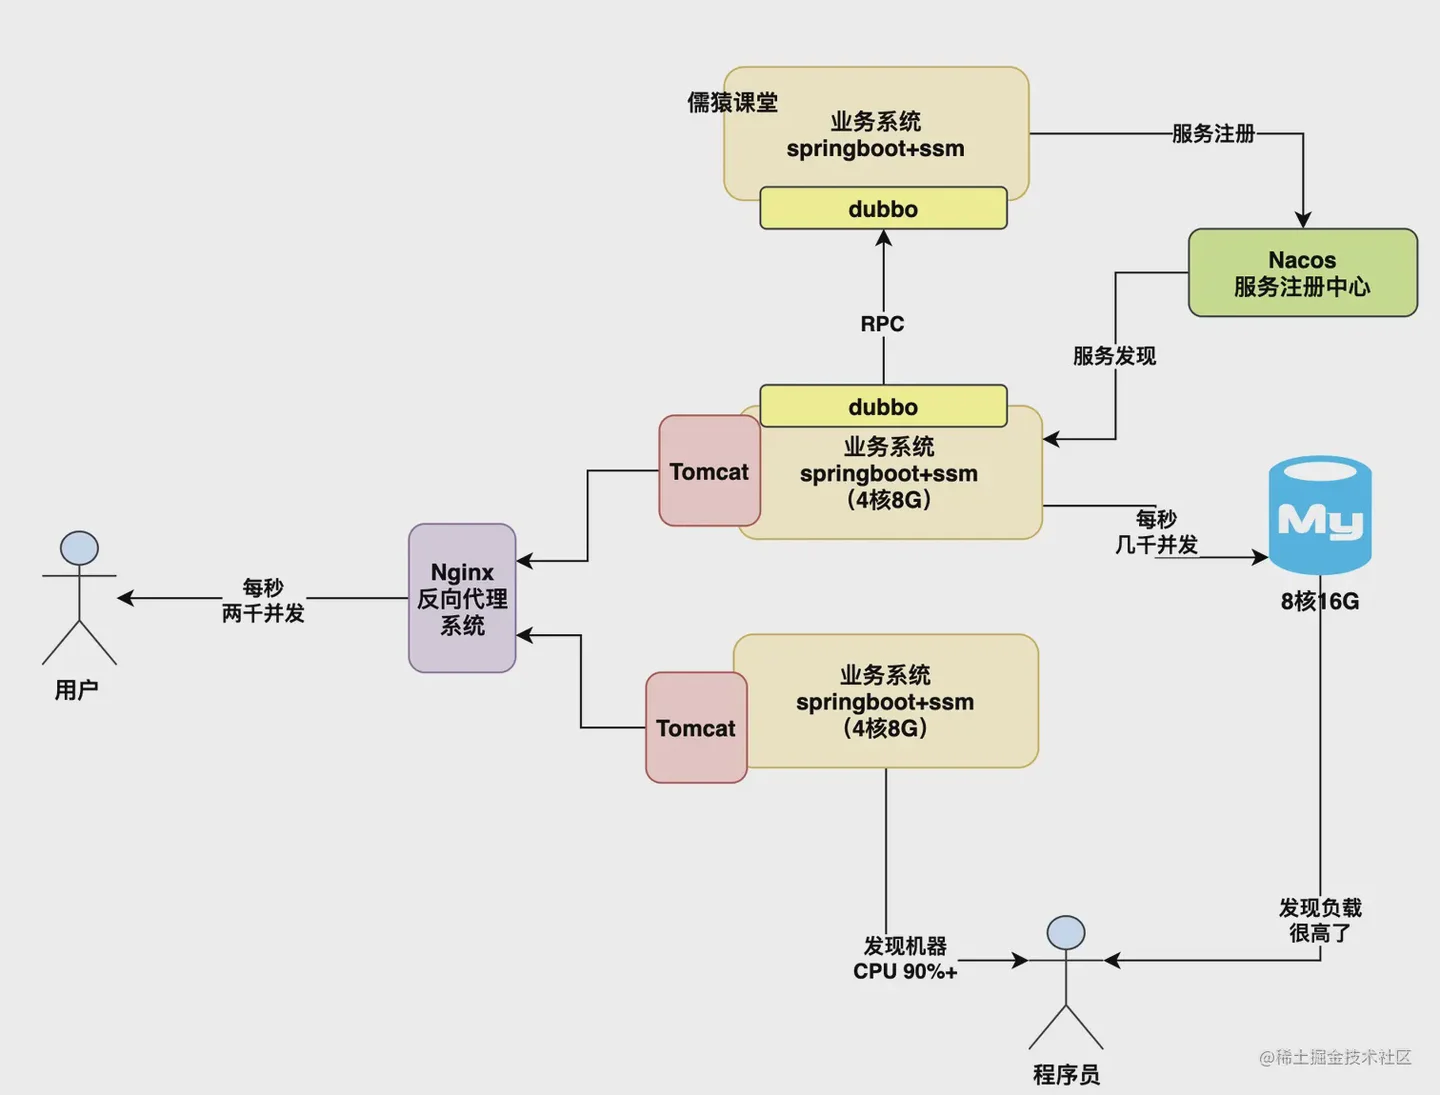
这就是 MySQL 高并发最反直觉的地方:瓶颈从来不在你加机器的那一层,而在最底下那台安静的数据库上。 应用层无状态,加机器就能扛;数据库有状态,数据就一份,所有人都得排队找它。网上关于高并发的文章千千万,但很多人照做之后效果平平,根源就在于没搞清楚压力的传导路径——你以为的”系统慢”,其实是”数据库快被压死了”。
这篇文章不谈玄乎的架构哲学,只拆四个最实在的维度:MySQL 到底能抗多少并发、SQL 层怎么抠出十倍性能、读写分离怎么避开那个著名的坑,以及什么时候才真的需要分库分表。
MySQL 不是不能抗,是你让它干得太糙
先说一个残酷的事实:单台 MySQL,硬件过得去、SQL 写得正常,扛个几千 QPS 完全没问题。那为什么你的系统几百并发就喘?
看看它的内部结构就明白了。每一个请求进来,都要建立连接、解析 SQL、优化执行计划、访问存储引擎,一路层层过关。连接的创建和销毁本身就是昂贵操作,高并发下如果每个请求都新建连接,光是握手就把数据库拖垮了。
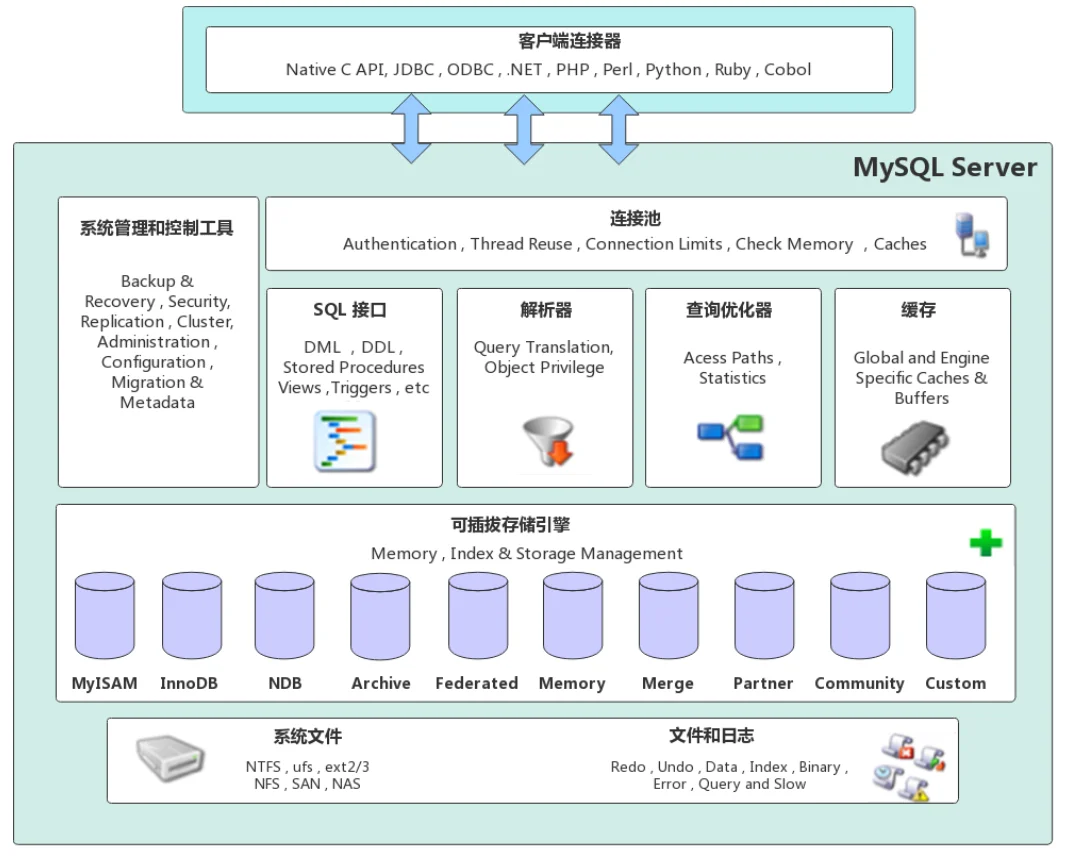
所以第一个动作永远是标配:连接池。应用侧用连接池复用连接,数据库侧把 max_connections 调到和实际负载匹配的值,再配合 thread_cache_size 缓存线程。第二个动作是喂饱 InnoDB 的 Buffer Pool——把它设到物理内存的 60%~80%,让热点数据尽量留在内存里,而不是每次都去敲磁盘的门。
有团队做过对比:一台裸奔的 MySQL 配置文件改完这两个参数,同样的负载,响应时间直接腰斩。不花一分钱,先榨干单机的潜力,这是性价比最高的一步,可惜一半的团队跳过了它。
一条烂 SQL,能吃掉十台服务器的预算
解决了连接问题,接下来是重头戏:SQL 本身。
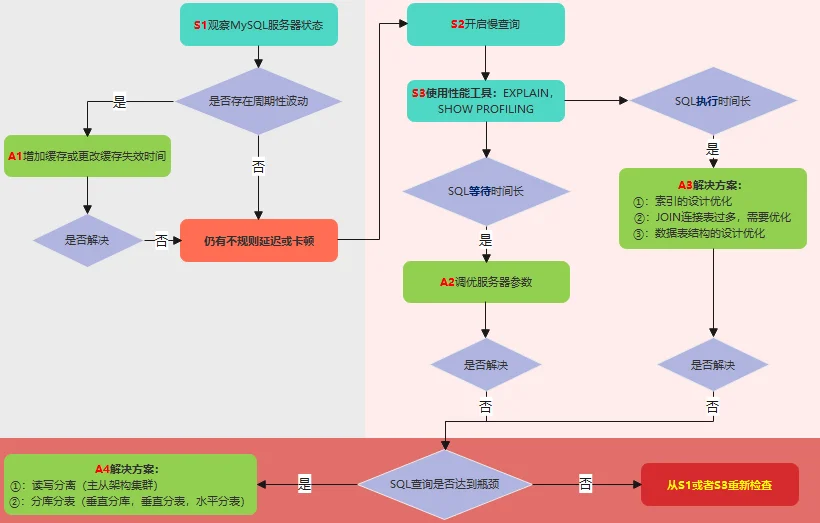
我见过太多团队,数据库都快挂了,慢查询日志一拉,排在前面的永远是那几条——没走索引的全表扫描、LIKE '%关键字%' 这种让索引直接作废的写法、对大表随手 SELECT * 再内存里慢慢过滤。一条全表扫描的 SQL,并发一上来就是几百个线程同时扫几百万行,CPU 不爆表才怪。
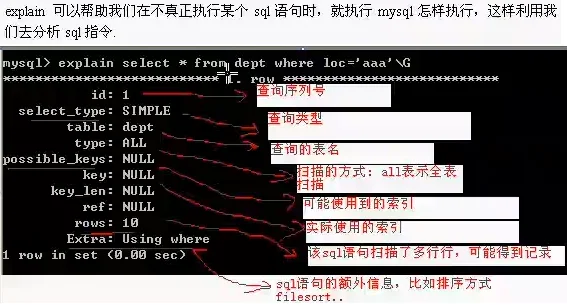
排查的武器就摆在手边:EXPLAIN。任何一条可疑的 SQL,前面加上这个词,执行计划摊开在眼前——type=ALL 就是全表扫描,rows 大到离谱就是灾难预告。配合慢查询日志(long_query_time 设成 1 秒甚至 0.5 秒),让每一条懒 SQL 无处遁形。
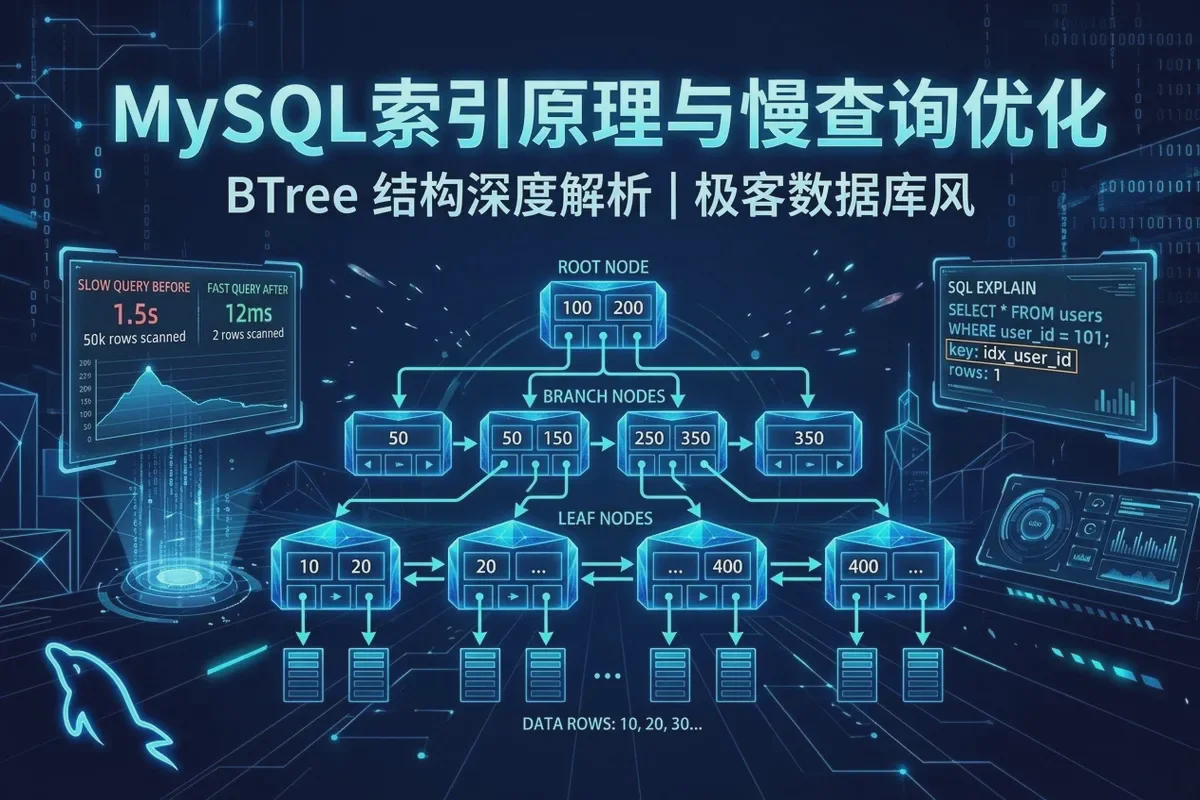
实操里有几个高频踩坑点值得记牢:索引列上套函数、用 OR 连接没索引的列、隐式类型转换(字符串字段传数字)、联合索引不满足最左前缀——每一条都会让优化器默默放弃索引。美团技术团队那篇经典的《MySQL索引原理及慢查询优化》值得每个后端放在收藏夹里,十条老文章,到今天依然条条见血。
一句话:索引不是建了就完事,得让 EXPLAIN 替你把关。
读写分离:用了都说好,那个坑却人人踩
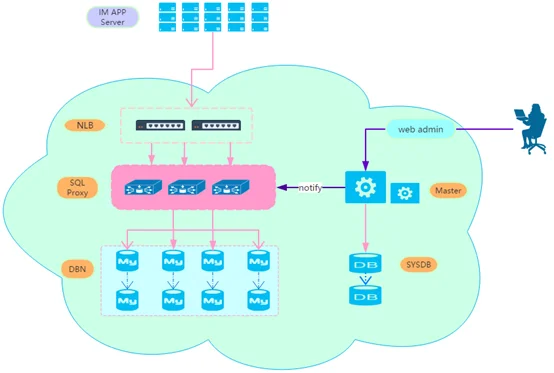
单机优化到头了,下一步自然是加帮手。绝大多数业务都是读多写少——内容社区读请求能占 98%,电商商品页更是如此。那就读写分离:一个主库管写,几个从库管读,主从之间靠 binlog 同步。
有内容平台做过实测:1 主 3 从,配合 ShardingSphere 这类中间件自动路由,主库 CPU 从 95% 降到 45%,读 QPS 从 3000 涨到 9000。这买卖划算。
但读写分离有个教科书级的坑,上线必踩:主从延迟。
从库拿主库的数据是异步的,快的几十毫秒,慢的能到秒级。于是经典的客诉来了——用户充了 100 块,页面显示余额没变,电话打爆客服:”你们平台吞钱!”其实就是写进了主库,读的时候走了从库,旧数据。
解法不复杂,关键在分级:
- 钱、订单这类要命的数据,强制读主库,宁可慢一点,不能错一分;
- 内容列表、推荐流这类”旧一点无所谓”的,放心读从库;
- 配一个主从延迟监控,延迟超过阈值自动告警甚至临时切主。
还有个隐性成本很多人没算:读写分离放大的主要是读能力,写压力全在主峰上。如果你的业务是写密集——比如订单每秒几万笔——读写分离也救不了,这才是真瓶颈的信号。
分库分表,是止痛药,也是慢性手术
最后一层:单表数据涨到千万级、写库真的扛不住了,才轮到分库分表登场。
效果确实猛。某订单表 8000 万行,查询要 5 秒;按用户 ID 拆成 16 张表,单表 500 万行,查询回到 50 毫秒,性能提升一百倍。备份时间从 6 小时缩到半小时,索引重建从 4 小时缩到 15 分钟。
但代价同样真实:跨表 JOIN 没了,”我关注的用户列表”这种查询得拆成”先查关系再批量查用户”;全局唯一 ID 得换雪花算法;分布式事务成了新课题。分库分表不是优化,是一场伤筋动骨的数据迁移手术。
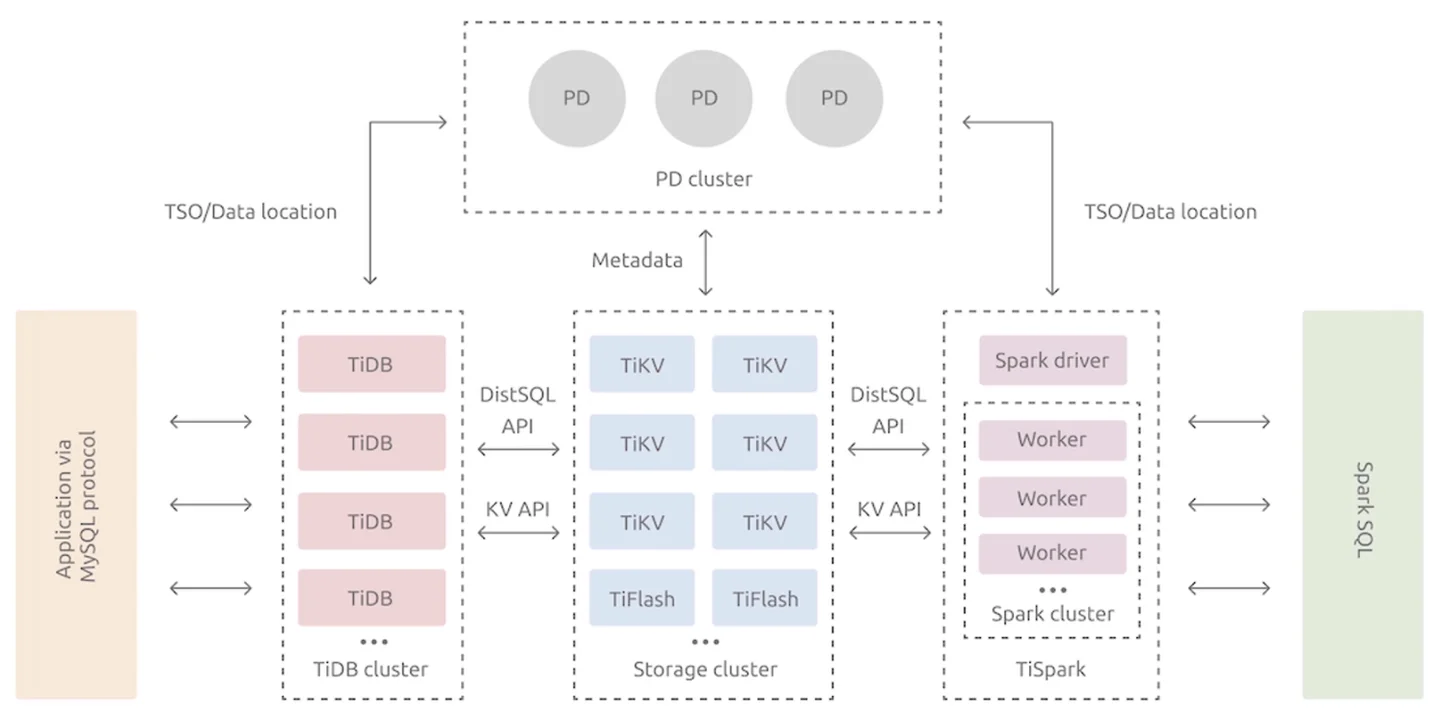
也正因为这套手术太痛,近几年分布式数据库成了新出路。TiDB、OceanBase 这类产品把分片逻辑下沉到数据库内部,应用层还是当单库用,三维家这类企业甚至直接把核心库整个迁到 OceanBase 上。2026 年的今天,”自建分库分表”和”上分布式数据库”已经是摆在技术负责人面前的两条路——前者省钱费人,后者省人费钱,没有标准答案,只有合不合适的生意账。
最后泼一盆冷水:很多系统根本走不到分库分表那一步。腾讯云开发者社区那篇《MySQL 高并发处理与数据一致性保障策略》里有个判断我很认同——高并发的架构演进应该跟着业务规模走,日活不到一万就上微服务和分库分表,纯属给自己加戏。某金融系统只是把事务范围收短、隔离级别从 REPEATABLE READ 降到 READ COMMITTED,死锁率就降了 92%。先治SQL,再谈架构,这个顺序反了,多少钱都不够烧。
写到这,想起一位老 DBA 跟我说过的话:数据库就像一口井,水位下降的时候,聪明人不急着挖新井,先看看是不是有人在水龙头上装了水泵。
你的系统里,那根最粗的水管,接对地方了吗?
(欢迎留言说说你踩过最冤的数据库坑——是那条跑了三年的全表扫描,还是那个半夜两点的主从延迟告警?)