
双 11 零点,你盯着购物车里的那台手机,倒数三、二、一,点下“提交订单”——页面转了几圈,弹出一句“系统繁忙,请稍后再试”。
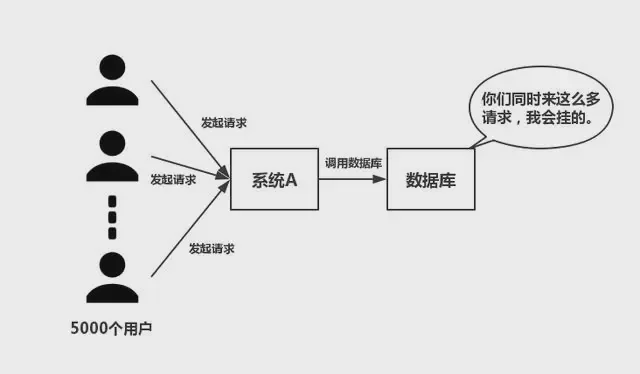
你大概不知道,此刻后台那台 MySQL 正在经历什么:几万条请求瞬间砸过来,就像几千人同时挤进一家小餐馆点菜,后厨统共三个厨师,锅铲都抡冒烟了,菜还是上不来。
有个数据很多人第一次听都不信:MySQL 单机跑到 2000 QPS 左右,就开始亮红灯了。这不是它不行,是它的定位本来就不是“抗洪大坝”,而是“精密仪器”——擅长把每一笔账算得清清楚楚,不擅长同时应付一万个人拍桌子。
所以高并发这件事,从根上就搞反的人太多了。他们第一反应是:升配置、换机器。钱花了不少,大促一来,该崩还是崩。
问题出在哪?出在一个认知误区上——高并发从来不是“让数据库更能扛”,而是“别让数据库扛”。
这几年翻遍了掘金、腾讯云开发者社区、JavaGuide 上的实战复盘,我发现大家趟出来的路其实就四条。一条条说。
别什么都让主库自己扛:读写分离,先把“读”分流出去
先看一个真实案例。某内容社区,每天新增 10 万条内容,阅读量却有 500 万次——典型的读多写少,读请求占 98%。
最开始所有请求全打在一个主库上。高峰期主库 CPU 飙到 95%,连接数冲到 800(上限 1000),用户刷不出内容,投诉每天 200 多条。更要命的是,大量 SELECT 把资源占死了,写操作(发帖、点赞)也跟着变慢。
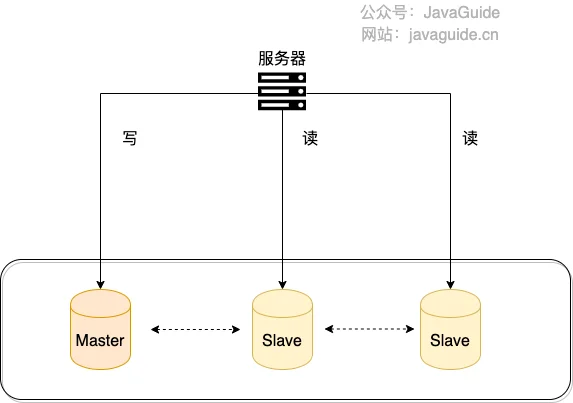
解法说穿了一文不值:1 主 3 从。写操作走主库,读操作分摊到 3 个从库,用 ShardingSphere-JDBC 做自动路由,应用层基本无感。
效果是真金白银的:主库 CPU 从 95% 降到 45%,读 QPS 从 3000 拉到 9000,投诉量掉下去 90%。
但这套方案有个坑,踩过的人不少:主从延迟。
复制是有时间的,通常 100 到 500 毫秒。某支付系统就翻过车——用户充完钱立刻查余额,看到的是旧数字,投诉“钱充了余额没变”。谁的责任?数据库没坏,是请求被路由到了还没同步完的从库。
现在的主流做法是“智能路由”:写完之后的一小段窗口内,同一个用户的读请求强制走主库(代码里用 ThreadLocal 打个标记就行);同时监控主从延迟,超过 1 秒就告警并自动切换。关键链路要“刚写完必须读到”,其余场景接受一点点延迟——鱼和熊掌,得按业务分着拿。
单表 8000 万行,神仙也救不了:该分表时就分表
第二个案例更常见。某电商订单表攒了 3 年数据,8000 万行,120GB。用户查“我的订单”,明明加了索引,还是要 3 到 5 秒。索引不是万能的,B+ 树层级太深,翻页如同大海捞针。
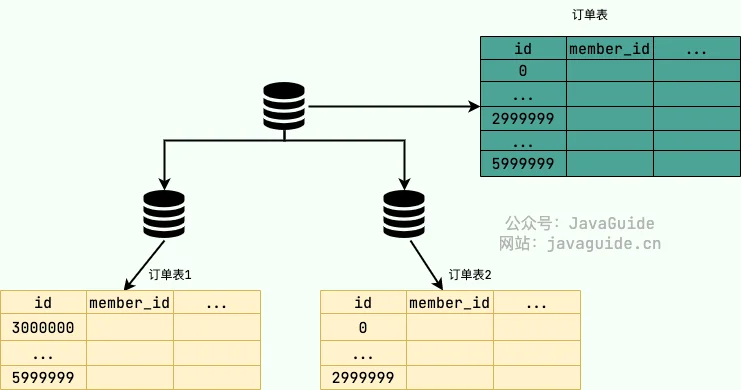
他们的做法:按 user_id 取模,拆成 16 张表,user_id % 16 决定数据进哪张,同一用户的数据永远在同一张表里,路由交给中间件。3 年前的冷数据归档到历史库。
结果:单表从 8000 万行降到 500 万行,查询从 5 秒降到 50 毫秒——整整 100 倍。备份时间从 6 小时缩到 30 分钟,索引重建从 4 小时缩到 15 分钟。
分库分表的坑,比读写分离深得多。
最惨的是扩容灾难。某社交平台用户从 1000 万涨到 1 亿,要从 4 分片扩到 16 分片。运维图省事,直接把哈希算法改成对 16 取模——结果 90% 的数据路由全错,服务直接不可用。正确姿势是四步走:新老规则双写一段时间、迁移工具逐批搬数据、灰度切流验证、确认无误再清理老分片。
还有一个隐形雷:分库之后,原来的数据库自增 ID 会撞车。两家分库可能生成同一个订单号。所以分布式 ID 生成器(比如雪花算法)成了标配。
给数据库请个保镖:缓存能挡子弹,但保镖自己也有软肋
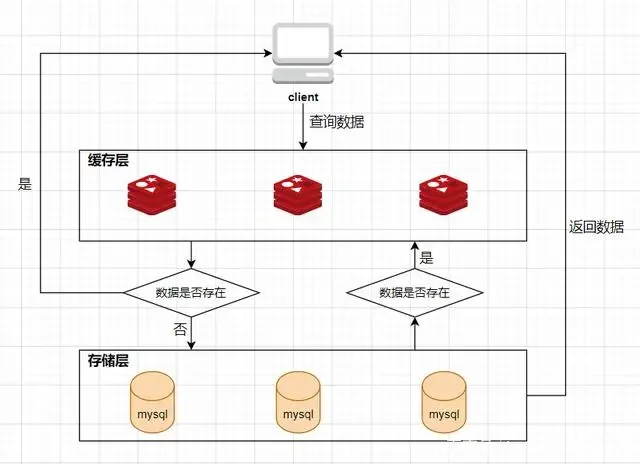
挡住读流量,最常用的保镖是 Redis。可很多人装了保镖就高枕无忧了,忘了保镖也有被打穿的时候。这三个场景,面试爱问,生产环境更爱出事。
缓存穿透:有人专查不存在的数据。黑客拿负数 ID、超大 ID 疯狂请求,缓存里没有,数据库里也没有,每一次都结结实实砸在 MySQL 上。三层防线:入口参数校验(负数直接拦)、缓存空值(短过期时间)、布隆过滤器(说没有,就一定没有)。
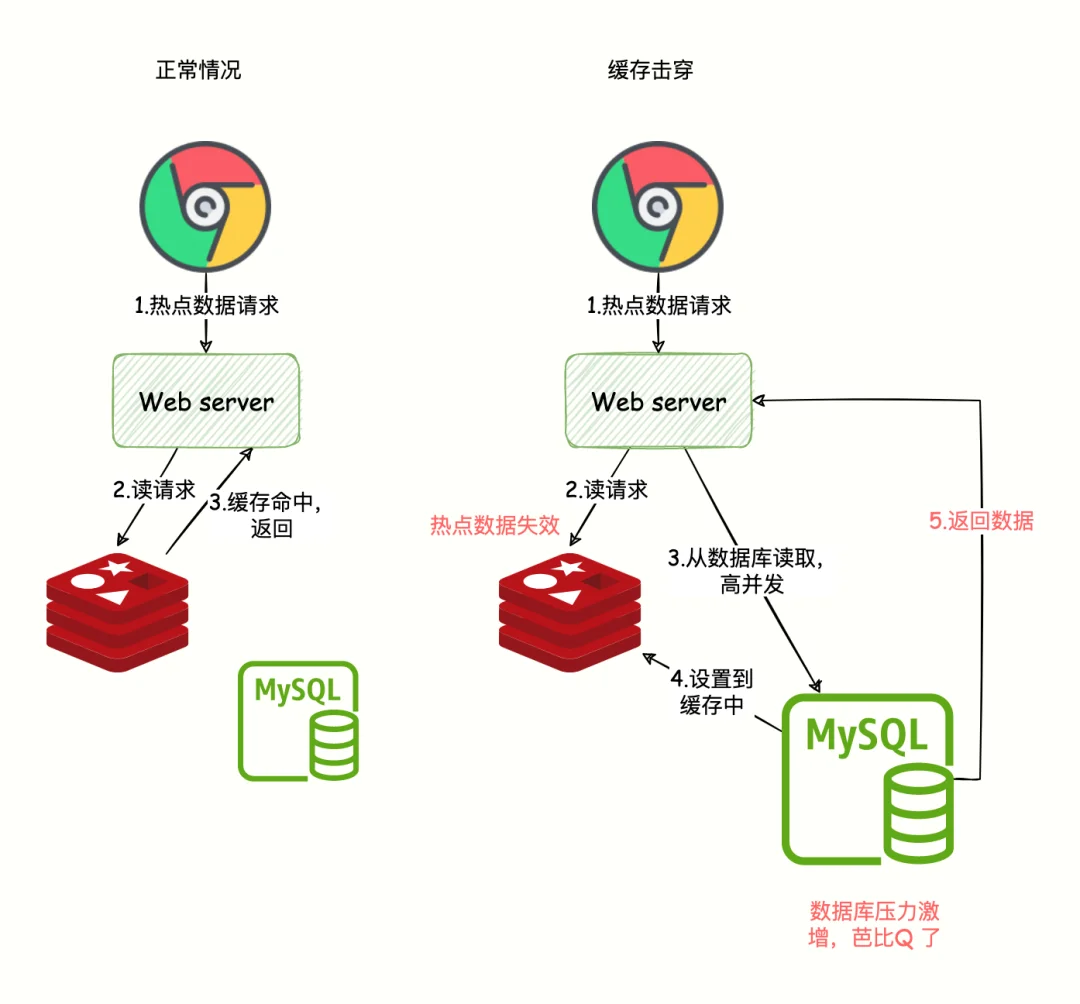
缓存击穿:一个热点 key 过期的瞬间,几万请求同时涌向数据库重建缓存,就像水库开闸。常用解法是给重建过程加互斥锁——只允许一个线程进数据库,其余线程等锁,或者干脆用“逻辑过期”:先返回旧数据,后台异步更新,用户最多看到几秒前的数据。
缓存雪崩:大面积 key 约好了似的同时间过期,请求全落数据库。最笨也最有效的招:给过期时间加随机值,别整齐划一都设 3 小时。
写流量扛不住?先存起来,按自己的节奏慢慢消化
最后这张牌,是秒杀场景的保命符。
秒杀的特点是:8 万 QPS 的冲击只持续十几秒。为这十几秒扩容数据库,要花几天甚至几周迁移数据,大促完再花几天缩容——亏到姥姥家了。
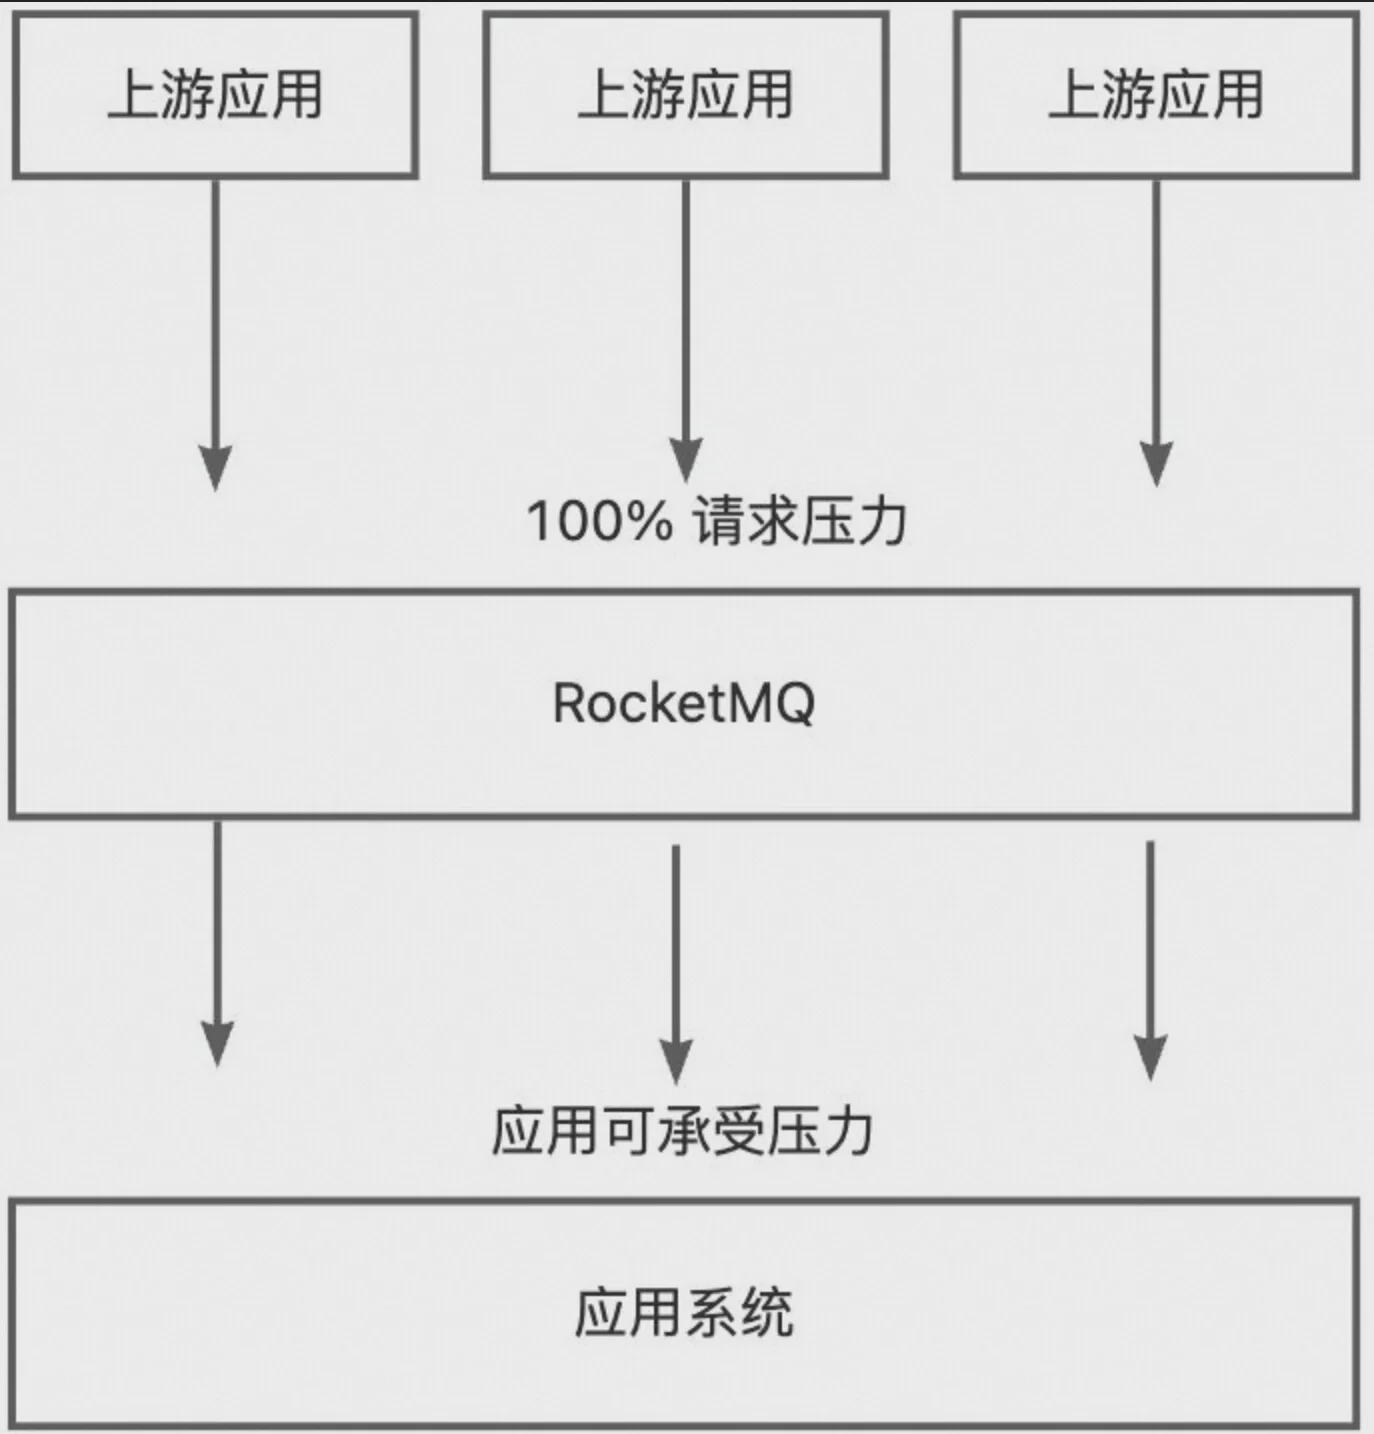
所以思路整个反过来:别让数据库面对洪峰,让洪峰先存进消息队列。
完整链路是这样的:库存提前预热进 Redis;用户请求进来,用 Lua 脚本原子性扣减库存(检查、判断、扣减三步绑在一起,从根本上防超卖);扣成功就发一条消息到 RocketMQ,前端立刻返回“抢购成功,订单处理中”;后端的消费者按自己能承受的节奏,从队列里取出请求,慢慢创建订单、写库。
数据库看到的永远是涓涓细流,不是滔天洪水。这就是“削峰填谷”。
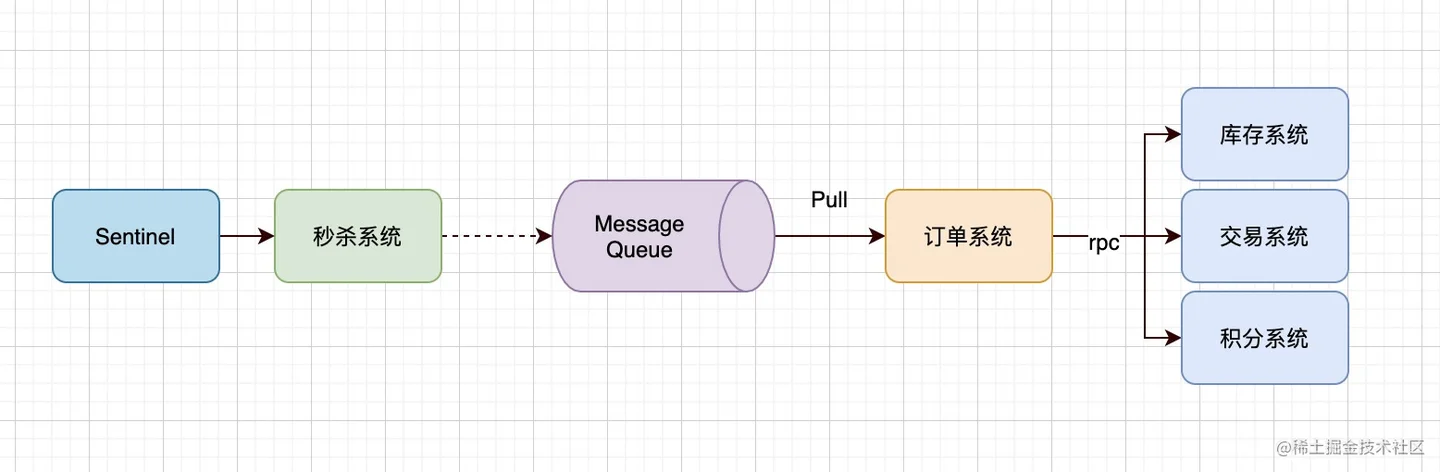
这套架构也有两个必须敬告的地方:一是幂等,网络抖动会让同一条消息被消费两次,得用“用户 ID + 商品 ID”去重,否则一个人下两单;二是队列要设最大长度,满了直接拒绝并返回“已抢完”,别让消息无限堆积把队列撑爆。
还有个细节值得多说一句:连接池别瞎配大。连接池最大连接数一般设成 CPU 核心数的 2 到 4 倍就够了,太大反而被上下文切换拖垮。配上 Prometheus 监控,连接数超过 max_connections 的 80% 就报警——别等数据库先喊疼,你才发现它病了。
写在最后
回头看这四招,其实说的是同一件事:MySQL 是账房先生,不是码头搬运工。读多了,找帮手(读写分离);账厚了,分账本(分库分表);常查的,记在小抄上(缓存);一时忙不过来,先把活儿排个号(消息队列)。
没有哪一招能包打天下,真正的高手,不过是提前想好了——流量砸下来的那一刻,哪一层该扛,哪一层该躲。
你的系统里,现在又是哪一层在硬扛呢?评论区聊聊。
(文中实战数据与踩坑案例整理自掘金、腾讯云开发者社区、JavaGuide、阿里云开发者社区等公开技术分享;配图来源见图片描述。)